
Обзор задач
Машинное обучение — это способ создания программ, которые обучаются на данных. Вместо того чтобы писать жёсткие правила «если — то», мы показываем программе множество примеров, а она сама находит в них закономерности. Затем эти знания применяются к новым, ранее не встречавшимся данным. Это похоже на то, как учится человек — на собственном опыте.
Качество результата зависит и от данных, и от выбранной модели. Большой объём данных сам по себе не гарантирует точность. Примеры должны быть правильными, разнообразными и соответствовать тем данным, с которыми модель встретится после обучения. Новые данные полезны, если они содержат дополнительную информацию о задаче. При этом слишком простая модель может не уловить зависимость даже на хорошем наборе данных.
Центральное понятие машинного обучения — модель. Модель машинного обучения — это построенное по данным правило, которое по признакам объекта вычисляет результат: класс, числовое значение, вероятность или принадлежность к кластеру.
Формально модель можно представить как функцию:
результат = f(признаки)
Алгоритм обучения строит эту функцию по обучающим данным. После обучения модель применяет найденное правило к новым объектам.
В программе модель представлена объектом некоторого класса. Например, DecisionTreeClassifier — класс модели, а переменная model хранит объект этого класса. Метод Fit обучает модель, после чего объект хранит результат обучения и может использоваться для предсказаний.
Устройство модели зависит от выбранного алгоритма. Линейная модель хранит коэффициенты, дерево решений — условия, KNN — обучающие примеры, а KMeans — центры кластеров.
Параметры и гиперпараметры
Заголовок раздела «Параметры и гиперпараметры»Во время обучения модель строится по данным. При этом важно различать параметры модели и гиперпараметры.
Параметры модели определяются автоматически во время обучения. Например, линейная модель подбирает коэффициенты, а дерево решений — условия разделения объектов.
Гиперпараметры задаются до обучения. Они управляют работой алгоритма и влияют на устройство модели. Например:
kзадаёт количество соседей в KNN;maxDepthограничивает глубину дерева решений;nTreesзадаёт количество деревьев в случайном лесе;learningRateзадаёт скорость обучения некоторых моделей.
Метод Fit строит модель по обучающим данным. Гиперпараметры обычно задаются при создании модели:
var model := new DecisionTreeClassifier(maxDepth := 4);model.Fit(Xtrain, ytrain);Подходящие значения гиперпараметров заранее неизвестны. Их подбирают по качеству модели на валидационных данных.
Основные задачи машинного обучения
Заголовок раздела «Основные задачи машинного обучения»В зависимости от типа результата различают три основные задачи:
- Классификация — отнесение объекта к одной из заранее известных категорий (классов).
- Регрессия — предсказание числового значения.
- Кластеризация — разбиение объектов на группы по схожести.
Классификация и регрессия относятся к обучению с учителем. Для каждого обучающего объекта заранее известен правильный ответ — значение целевой переменной. Модель учится находить связь между признаками и правильными ответами.
Кластеризация относится к обучению без учителя. Заранее известных правильных ответов нет: алгоритм сам ищет группы и другие закономерности в данных.
Библиотека ML PascalABC.NET позволяет создавать, обучать и использовать такие модели прямо в среде PascalABC.NET. Вам не нужно переходить на Python или другие языки. Всё делается в знакомом синтаксисе PascalABC.NET: от подготовки данных до обучения модели и оценки результата.
Рассмотрим эти задачи подробнее и для каждой приведём простые примеры.
Классификация
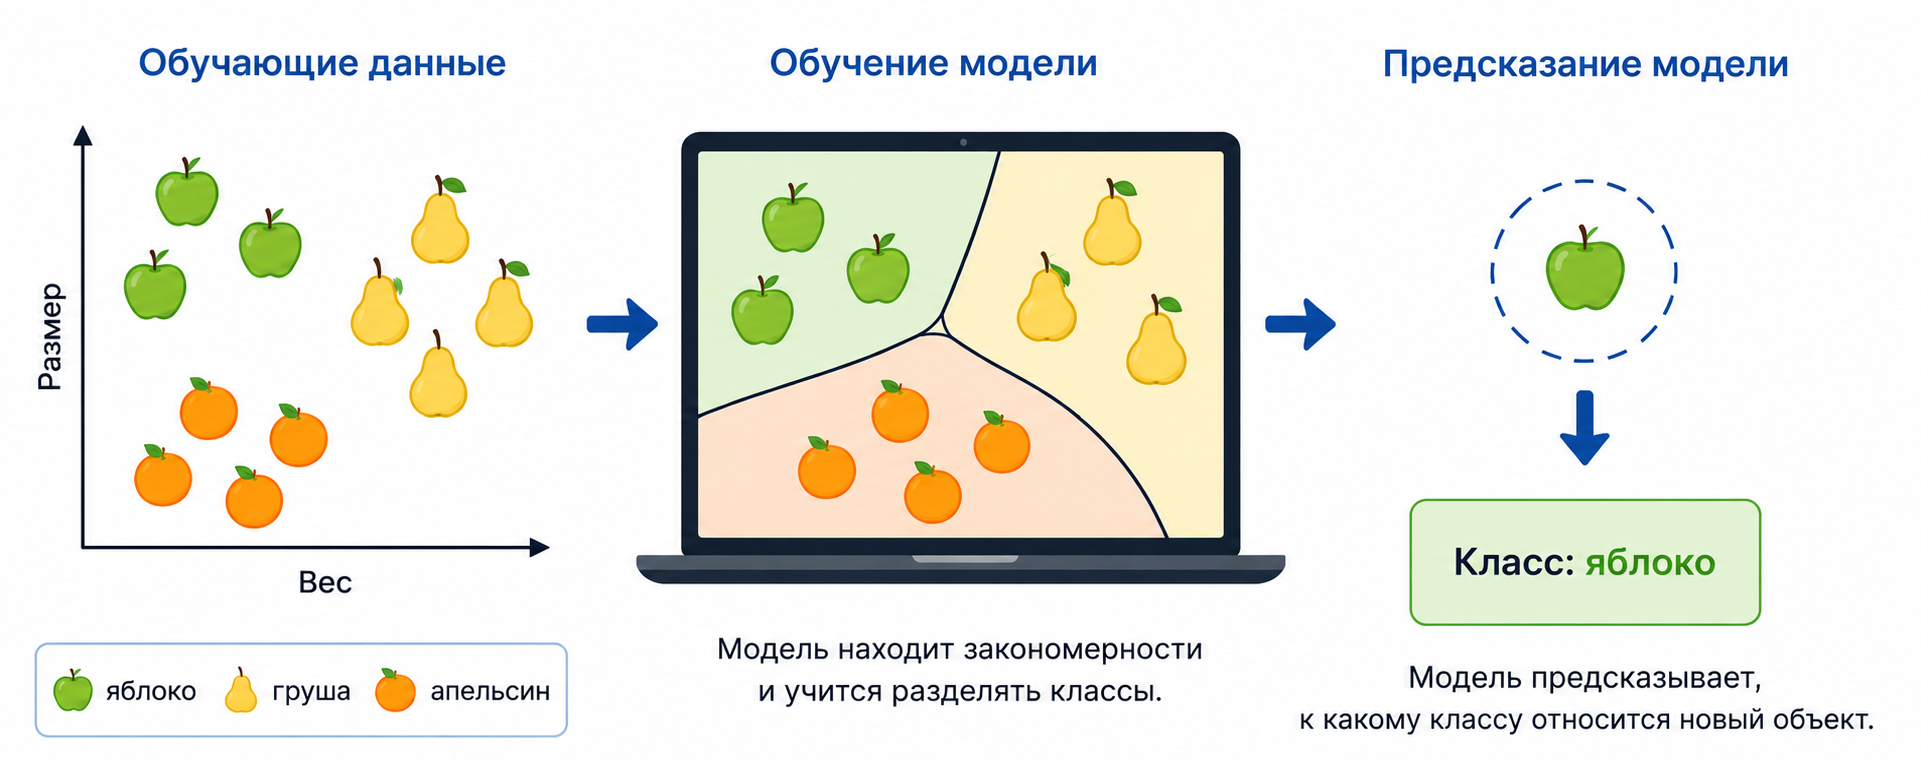
Заголовок раздела «Классификация»Классификация используется, когда нужно выбрать один из нескольких вариантов.
Например, модель может учиться отличать яблоки, груши и апельсины по признакам: размеру, весу, цвету и форме.
Другие примеры:
- понять, является ли письмо спамом;
- отнести товар к категории.
Результат классификации — класс: яблоко, груша, апельсин, spam / не spam, продано / не продано.
Регрессия
Заголовок раздела «Регрессия»Регрессия используется, когда нужно предсказать число.
Например, модель может предсказывать цену квартиры по её площади и, возможно, другим признакам: числу комнат, району, этажу или году постройки.

Другие примеры:
- оценить температуру завтра;
- спрогнозировать время доставки.
Результат регрессии — числовое значение.
Кластеризация
Заголовок раздела «Кластеризация»Кластеризация используется, когда заранее неизвестны правильные ответы, но нужно найти группы похожих объектов.
В отличие от классификации, здесь нет заранее заданных классов. Алгоритм сам ищет кластеры — группы объектов, которые похожи друг на друга по признакам.

Например:
- разбить покупателей на группы по поведению;
- найти похожие товары;
- обнаружить необычные объекты в данных.
Как обучается модель
Заголовок раздела «Как обучается модель»Для многих алгоритмов обучения с учителем процесс обучения можно представить как последовательность шагов.
- Выбирают вид модели и задают её гиперпараметры.
- Модель получает обучающие данные и делает предсказания.
- Предсказания сравниваются с правильными ответами. Функция потерь — это число, которое показывает, насколько предсказания модели отличаются от правильных ответов. Чем меньше значение функции потерь, тем меньше ошибка модели на обучающих данных.
- Метод
Fitподбирает параметры модели так, чтобы уменьшить значение функции потерь на обучающих данных.
В ML PascalABC.NET функция потерь обычно уже встроена в алгоритм. При вызове Fit её не нужно задавать отдельно.
После обучения модель оценивают на данных, которые не использовались при Fit. Для этого применяют метрики качества, например Accuracy, MAE или R².
Функция потерь и метрика качества выполняют разные задачи. Функция потерь помогает обучить модель, а метрика показывает, насколько хорошо работает уже обученная модель.
Эта схема подходит не для всех алгоритмов буквально. Например, KNN во время Fit запоминает обучающие объекты, а не подбирает коэффициенты. Однако общий порядок работы сохраняется: модель обучают на одних данных, а оценивают на других.
Как выбирать модель
Заголовок раздела «Как выбирать модель»Сначала нужно понять тип задачи:
- если ответ — категория, нужна классификация;
- если ответ — число, нужна регрессия;
- если правильных ответов нет, но нужны группы, нужна кластеризация.
После этого выбирают конкретную модель и проверяют её качество на данных, которые не использовались при обучении.